Google начал использовать загружаемые вами фото и аудио для обучения ИИ
Компания тихо обновила политику сбора данных: теперь медиафайлы из Google Lens, Translate и голосового поиска идут на тренировку моделей.

Содержание · 3
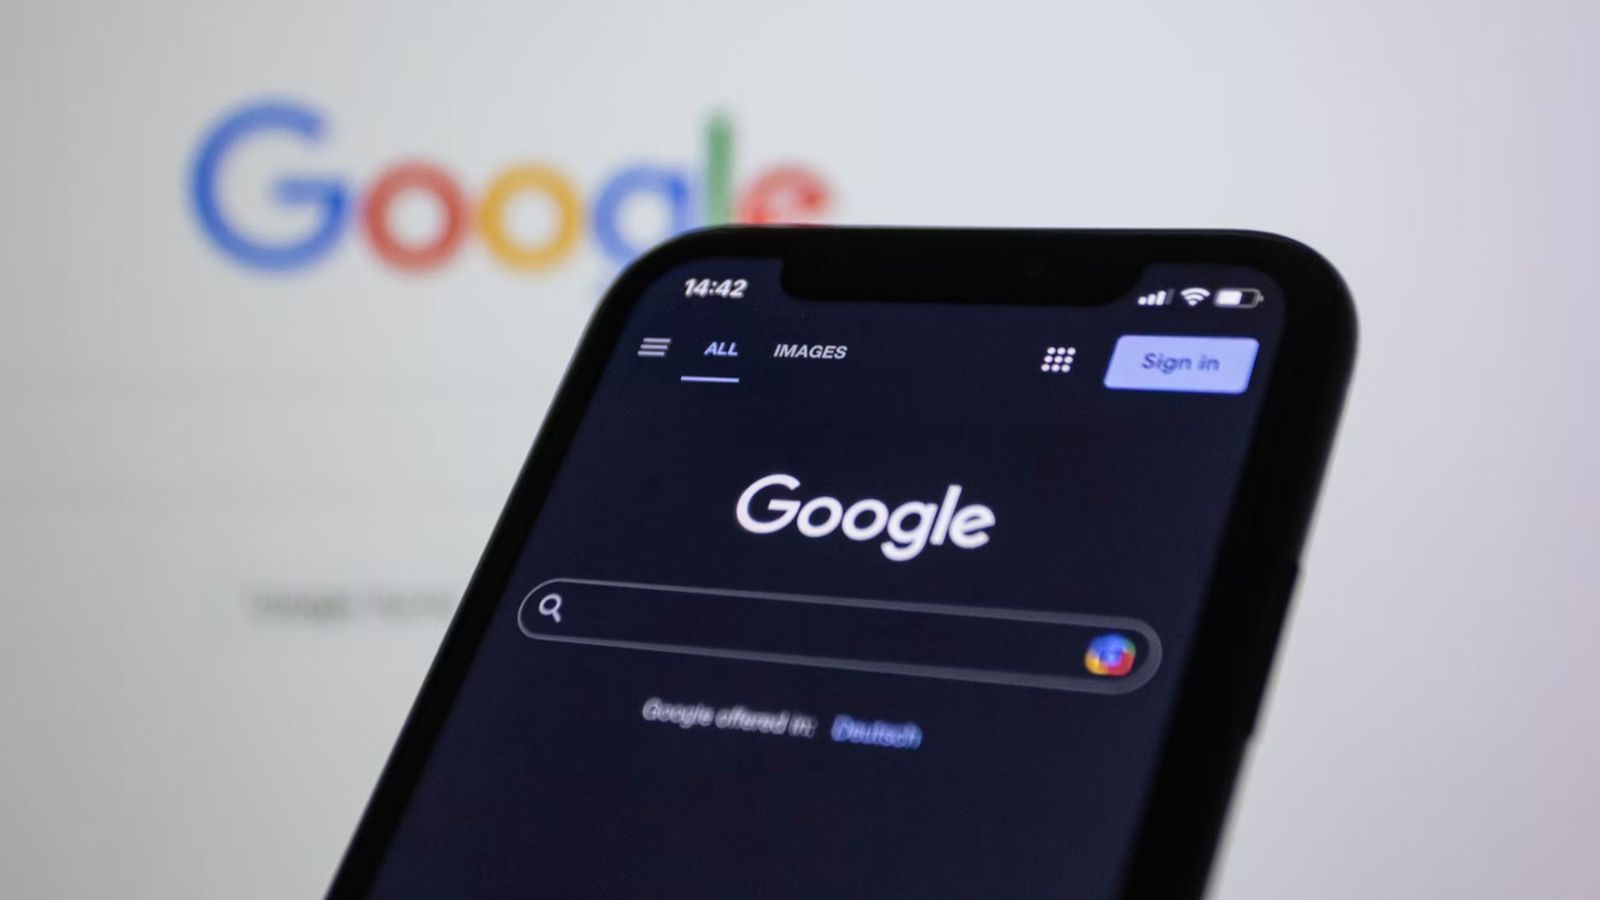
Google внёс изменения в политику обработки пользовательских данных — на этот раз без громких анонсов. Согласно материалу TechCrunch, компания получила право использовать медиафайлы, которые пользователи загружают в поисковые инструменты, для обучения своих ИИ-систем. Изменение затрагивает изображения, файлы, аудио- и видеозаписи — то есть практически любой контент, который вы отправляете через поисковые сервисы Google.
Все пользователи включены в эту схему по умолчанию. Чтобы отказаться, нужно самостоятельно изменить настройки — компания не уведомляла об этом явно.
Что именно собирает Google и откуда
Под действие новой политики подпадают несколько конкретных продуктов. Если вы загружаете фотографию в Google Lens для визуального поиска — этот снимок теперь может попасть в обучающую выборку. То же самое касается аудиозаписей, которые сопровождают запросы в голосовом поиске, и любых файлов, загружаемых через Google Translate.
Важная оговорка: изменение распространяется только на продукты, связанные с поиском. Личные фотографии в Google Photos пока не затронуты — они хранятся отдельно и под действие новой политики не подпадают. Однако формулировка «пока» здесь не случайна: компания последовательно расширяет периметр сбора данных.
За этим решением стоит вполне понятная логика. Генеративные ИИ-модели требуют огромных объёмов размеченных данных для обучения, а доступные публичные источники постепенно исчерпываются. Пользовательский контент — один из немногих оставшихся резервуаров, причём достаточно разнообразный и актуальный.
Как отключить сбор данных: пошаговая инструкция
Тем, кто не хочет, чтобы их загрузки использовались в этих целях, Google всё же оставил возможность выйти из схемы. Процесс состоит из двух шагов.
Первый: перейдите на страницу Search Services History и снимите галочку с пункта «Save Media». Второй: откройте страницу Search Services Personalization и убедитесь, что сохранение данных там тоже отключено. После этих двух действий ваши медиафайлы не будут попадать в обучающие датасеты.
Есть и ещё один лайфхак, не связанный с данными напрямую: если вы хотите отключить блок с AI Overview в результатах поиска Google, добавьте «-AI» в начало поискового запроса. Это временное решение, но оно работает.
Контекст: тренд, который касается всех
История с Google — не единичный случай, а часть более широкой тенденции. Крупные технологические компании одна за другой пересматривают пользовательские соглашения, чтобы легализовать использование контента для обучения ИИ. Раньше под удар попадали преимущественно текстовые данные и публичные посты в соцсетях. Теперь очередь дошла до медиафайлов.
Для белорусских пользователей и компаний это означает следующее: если ваши сотрудники используют Google Lens для распознавания документов, Google Translate для работы с коммерческой перепиской или голосовой поиск для рабочих задач — загружаемые при этом файлы теоретически могут оказаться в обучающих датасетах американской корпорации. Для большинства частных пользователей это вопрос личного комфорта. Для бизнеса, работающего с конфиденциальными данными клиентов, — потенциальный compliance-риск, особенно если компания ориентируется на европейские стандарты защиты данных.
Резидентам ПВТ и IT-компаниям, работающим с зарубежными заказчиками, стоит проверить, не используют ли их сотрудники поисковые инструменты Google для обработки чувствительных материалов — и при необходимости обновить внутренние регламенты по работе с данными.
Примечательно, что Google сделал отказ технически возможным, но организационно неудобным: два отдельных раздела настроек, ни одного уведомления на главной странице. Это стандартная практика для индустрии — opt-out вместо opt-in, когда согласие по умолчанию считается данным. Музыканты и художники, судившиеся с ИИ-компаниями за использование их творчества без разрешения, с этой логикой уже хорошо знакомы.
Свежие новости
Все новости
Rust 1.100.0: стабилизация типа ! и нового API аллокаторов
В Rust 1.100.0 стабилизированы тип never (!) и базовые части allocator API. Изменение затрагивает все издания языка и несёт ограниченный breaking change.
Google представила Gemini 4 Hydrogen: быстрая модель для повседневных задач и агентных сценариев
Google анонсировала Gemini 4 Hydrogen — модель, ориентированную на скоростное выполнение задач в агентных рабочих процессах и повседневном программировании. Она доступна во всех тарифах Google AI Studio, Gemini API и приложения Gemini, а также платным подписчикам Google AI Pro и Ultra в Google Antigravity.
AWS Emulator: локальное тестирование AWS-приложений без аккаунта и деплоя
AWS выпустила AWS Emulator — инструмент для сборки и тестирования AWS-приложений локально или в CI-среде без AWS-аккаунта и деплоя. Эмулятор принимает стандартные вызовы SDK и CLI и отвечает на них за миллисекунды.
DeepSeek-V4-Pro, V4-Flash и V4.1-Flash появились в Amazon SageMaker JumpStart
Amazon SageMaker JumpStart пополнился тремя моделями DeepSeek: флагманской V4-Pro, экономичной V4-Flash и мультимодальной V4.1-Flash с архитектурой CED. Все три распространяются под лицензией MIT и поддерживают контекстное окно в 1 млн токенов.
Amazon S3 Tables получили поддержку серверного журналирования доступа
Amazon S3 Tables теперь поддерживают серверное журналирование доступа: детальные записи о запросах к табличным бакетам помогают отслеживать операции с таблицами, управление пространствами имён и доступ к данным для аудита безопасности, анализа доступа и распределения затрат.
Google открыла доступ к Gemini 4 Carbon для разработчиков
Google запустила Gemini 4 Carbon — модель с заявленными возможностями в кибербезопасности и длительных агентных рабочих процессах. Доступ открыт через платный уровень API.
Amazon S3 Access Grants научился перечислять гранты сразу по нескольким AWS-аккаунтам
Amazon S3 Access Grants получил поддержку кросс-аккаунтного листинга: один вызов ListCallerAccessGrants возвращает гранты из всех инстансов, расшаренных через AWS RAM, без необходимости опрашивать каждый аккаунт отдельно.
Google Maps Platform теперь доступна в AI Studio
Google добавила поддержку Maps Platform в AI Studio: разработчик описывает идею, Gemini генерирует код, а студия автоматически подключает ключ API и показывает живой интерактивный превью.
AWS выпустила open-source UI для графовой аналитики поверх data lake
AWS представила open-source решение с локальным веб-интерфейсом, которое позволяет превращать записи из data lake в графы для анализа в Amazon Neptune Analytics — без ручной сборки ETL-пайплайнов.