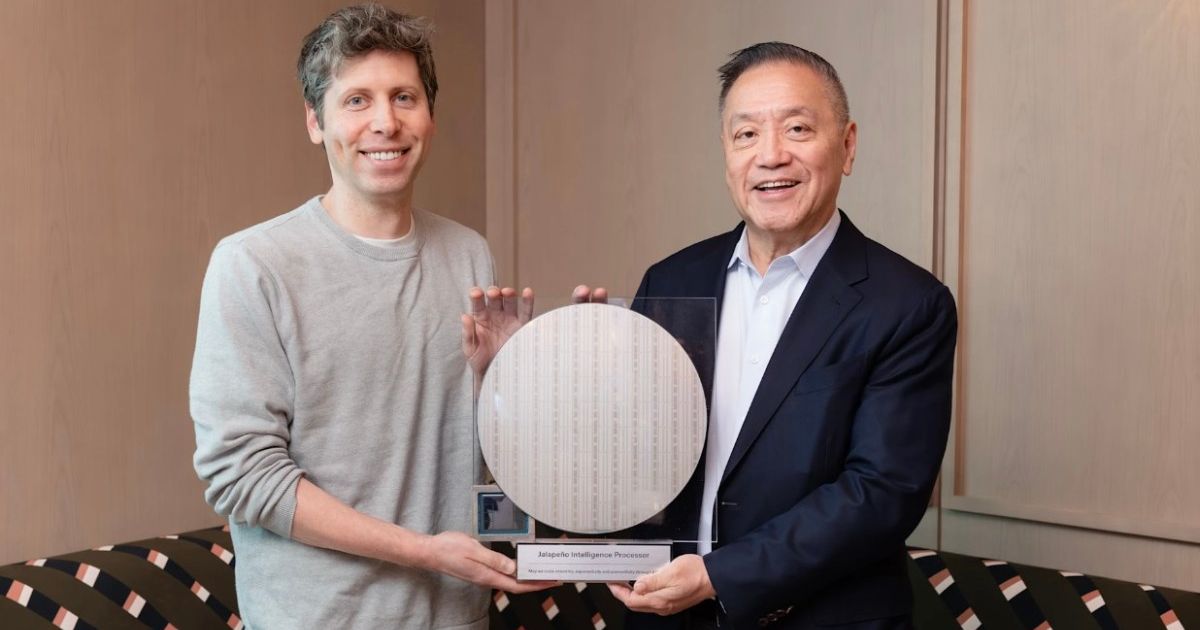
OpenAI представила первый собственный чип Jalapeño, разработанный совместно с Broadcom
Компания делает ставку на снижение зависимости от Nvidia и удешевление инференса — ключевого звена в экономике AI-продуктов.

Содержание · 3
OpenAI представила первый собственный инференс-процессор под названием Jalapeño — разработан совместно с Broadcom и ориентирован исключительно на задачи запуска готовых AI-моделей. По данным компании, ранние тесты демонстрируют заметно более высокую производительность на ватт по сравнению с актуальными альтернативами. Чип пока проходит тестирование, но само его появление меняет расстановку сил на рынке AI-инфраструктуры.
Партнёрство с Broadcom было официально объявлено ещё в октябре 2025 года, однако слухи о том, что OpenAI работает над собственным кремнием, ходили значительно дольше. Главный мотив — снизить критическую зависимость от Nvidia, чьи GPU сегодня обеспечивают большую часть вычислительной мощности компании. По этому пути уже прошли Google (чипы TPU) и Amazon (Trainium/Inferentia) — оба технологических гиганта создали собственные AI-акселераторы именно для того, чтобы не зависеть от одного поставщика и контролировать себестоимость инференса.
Почему инференс, а не обучение
Jalapeño заточен под конкретную задачу: инференс — то есть запуск уже обученных моделей в ответ на запросы пользователей. Это не то же самое, что предобучение (pre-training), которое требует колоссальных вычислительных ресурсов. OpenAI особо подчеркнула эффективность чипа при работе с моделями для генерации кода в реальном времени — одним из самых быстрорастущих сегментов её продуктового портфеля.
Предобучение новых фронтирных моделей, по всей видимости, по-прежнему будет опираться на оборудование Nvidia. Но именно инференс — это то, что происходит миллиарды раз в сутки, когда пользователи обращаются к ChatGPT, Codex и другим продуктам компании. Даже незначительное снижение стоимости одного запроса в масштабах такого трафика превращается в сотни миллионов долларов экономии в год.
Президент OpenAI Грег Брокман объяснил логику в подкасте компании, записанном вскоре после объявления партнёрства с Broadcom:
««У нас глубокое понимание рабочей нагрузки. Мы искали конкретные задачи, которые недостаточно хорошо обслуживаются существующими решениями, и спрашивали себя: как построить что-то, что позволит ускорить то, что сейчас невозможно?»»
Примечательно, что в разработке Jalapeño участвовали собственные AI-модели OpenAI — компания использовала свои инструменты для проектирования кремния. Это не просто маркетинговый тезис: применение генеративных моделей в chip design — активно развивающееся направление, которым занимаются также Google DeepMind и ряд стартапов.
Вертикальная интеграция как стратегия
Появление Jalapeño — часть более широкой стратегии вертикальной интеграции. OpenAI строит агентные продукты вроде Codex, разрабатывает модели, возводит собственные дата-центры и теперь проектирует чипы под конкретные рабочие нагрузки. Компания прямо сформулировала этот подход в официальном заявлении:
««OpenAI не только разрабатывает фронтирные модели и строит продукты поверх них — она проектирует инфраструктуру под ними: архитектуру чипов, ядра, системы памяти, сетевое взаимодействие, планировщики, системы деплоя и пользовательский опыт. Поскольку OpenAI работает на всех уровнях стека, каждый слой можно оптимизировать вокруг единой цели: делать модели быстрее, надёжнее и доступнее для пользователей.»»
Эта логика хорошо знакома тем, кто следит за Apple: компания десятилетиями строила преимущество именно через контроль над железом и программным обеспечением одновременно. OpenAI движется в том же направлении, только в контексте AI-инфраструктуры.
Для рынка это означает, что конкуренция в сегменте AI-акселераторов будет только усиливаться. Nvidia остаётся доминирующим игроком, но появление кастомных чипов от крупнейших потребителей GPU — Google, Amazon, Microsoft (через партнёрства) и теперь OpenAI — постепенно сужает её монополию на рынке AI-вычислений.
Что это значит для белорусского IT-рынка
Для белорусских компаний, работающих в сфере AI и машинного обучения, тренд на кастомные чипы пока остаётся далёким горизонтом — собственное производство кремния требует инвестиций, недоступных даже большинству крупных мировых игроков. Однако косвенные последствия вполне ощутимы уже сейчас.
Снижение стоимости инференса у OpenAI и конкурентов напрямую влияет на цены API, которыми пользуются белорусские разработчики и стартапы из ПВТ. Чем дешевле обходится запуск модели на стороне провайдера, тем ниже порог входа для продуктов, встраивающих AI-функциональность. Это особенно актуально для компаний, строящих B2B-решения на базе языковых моделей: снижение операционных расходов на AI-слой улучшает юнит-экономику и делает продукты конкурентоспособнее на международных рынках.
Кроме того, сам факт того, что крупнейшие AI-компании инвестируют в вертикальную интеграцию вплоть до уровня кремния, говорит о зрелости отрасли. AI перестаёт быть надстройкой над чужой инфраструктурой и превращается в самостоятельный технологический стек — со своей физикой, экономикой и конкурентными барьерами.
Свежие новости
Все новости
Amazon S3 Access Points для FSx расширили региональное покрытие
AWS расширила доступность S3 Access Points для файловых систем Amazon FSx: FSx for NetApp ONTAP получила поддержку в 4 новых регионах, FSx for OpenZFS — в 20. Данные остаются на файловой системе, но становятся доступны через S3 API для сервисов ИИ, аналитики и бессерверных вычислений.


Claude Fable 5.2 доступен в Vercel AI Gateway
Anthropic Claude Fable 5.2 появился в Vercel AI Gateway. Модель ориентирована на открытые технические задачи: кодирование, рассуждение и компьютерное зрение. Доступ требует хранения данных — ZDR не поддерживается.

Google открыла TPU Sync: библиотека для управления KV-кэшем и весами моделей на TPU
Google выпустила TPU Sync — открытую C++-библиотеку, которая организует передачу тензоров между HBM, оперативной памятью хоста, локальными SSD и сетевым хранилищем как единой иерархией памяти. Для MoE-моделей от 235B до 480B параметров библиотека сокращает задержку передачи KV-кэша и время до первого токена в среднем на 90% по сравнению с работой без TPU Sync.

Cloud Pathways для GKE перешёл в статус GA
Google Cloud объявил об общей доступности Cloud Pathways на Google Kubernetes Engine. Среда выполнения, созданная в Google DeepMind для обучения и инференса фронтирных моделей, включая Gemini, теперь открыта для всех клиентов платформы.

NVIDIA Dynamo получил рецепты развёртывания для ведущих корейских открытых моделей
NVIDIA выпустила оптимизированные рецепты развёртывания на базе Dynamo для четырёх корейских открытых моделей. Конфигурации рассчитаны на GPU NVIDIA B200 и заявляют до двукратного прироста производительности из коробки.

Copilot Impact Dashboard теперь показывает Chat и VS Code Agents
GitHub обновил Copilot Impact Dashboard: диаграмма принятия теперь охватывает девять функций, включая Copilot Chat и окно VS Code Agents. Когорта «Passive users» переименована в «Chat-first users».

AWS Agent Registry стал доступен в регионе GovCloud (US-West)
Amazon Bedrock AgentCore расширил географию: AWS Agent Registry теперь доступен в регионе AWS GovCloud (US-West), предназначенном для организаций государственного сектора США и их партнёров.
AWS Elemental MediaConvert получил встроенную генерацию субтитров на базе ИИ
AWS Elemental MediaConvert интегрировал Smart Subtitles — решение на основе ИИ и современных моделей распознавания речи. Функция автоматически транскрибирует аудио и встраивается непосредственно в VOD-пайплайны без внешних сервисов субтитрования.
Vercel CLI получил флаг автоудаления новых проектов
В Vercel CLI v65.12.0 появился флаг --delete-project-after: при создании нового проекта через vercel deploy можно задать срок, по истечении которого проект удалится автоматически.